 Ilies Allali
Pourquoi j’ai ouvert le code de Parenthèse
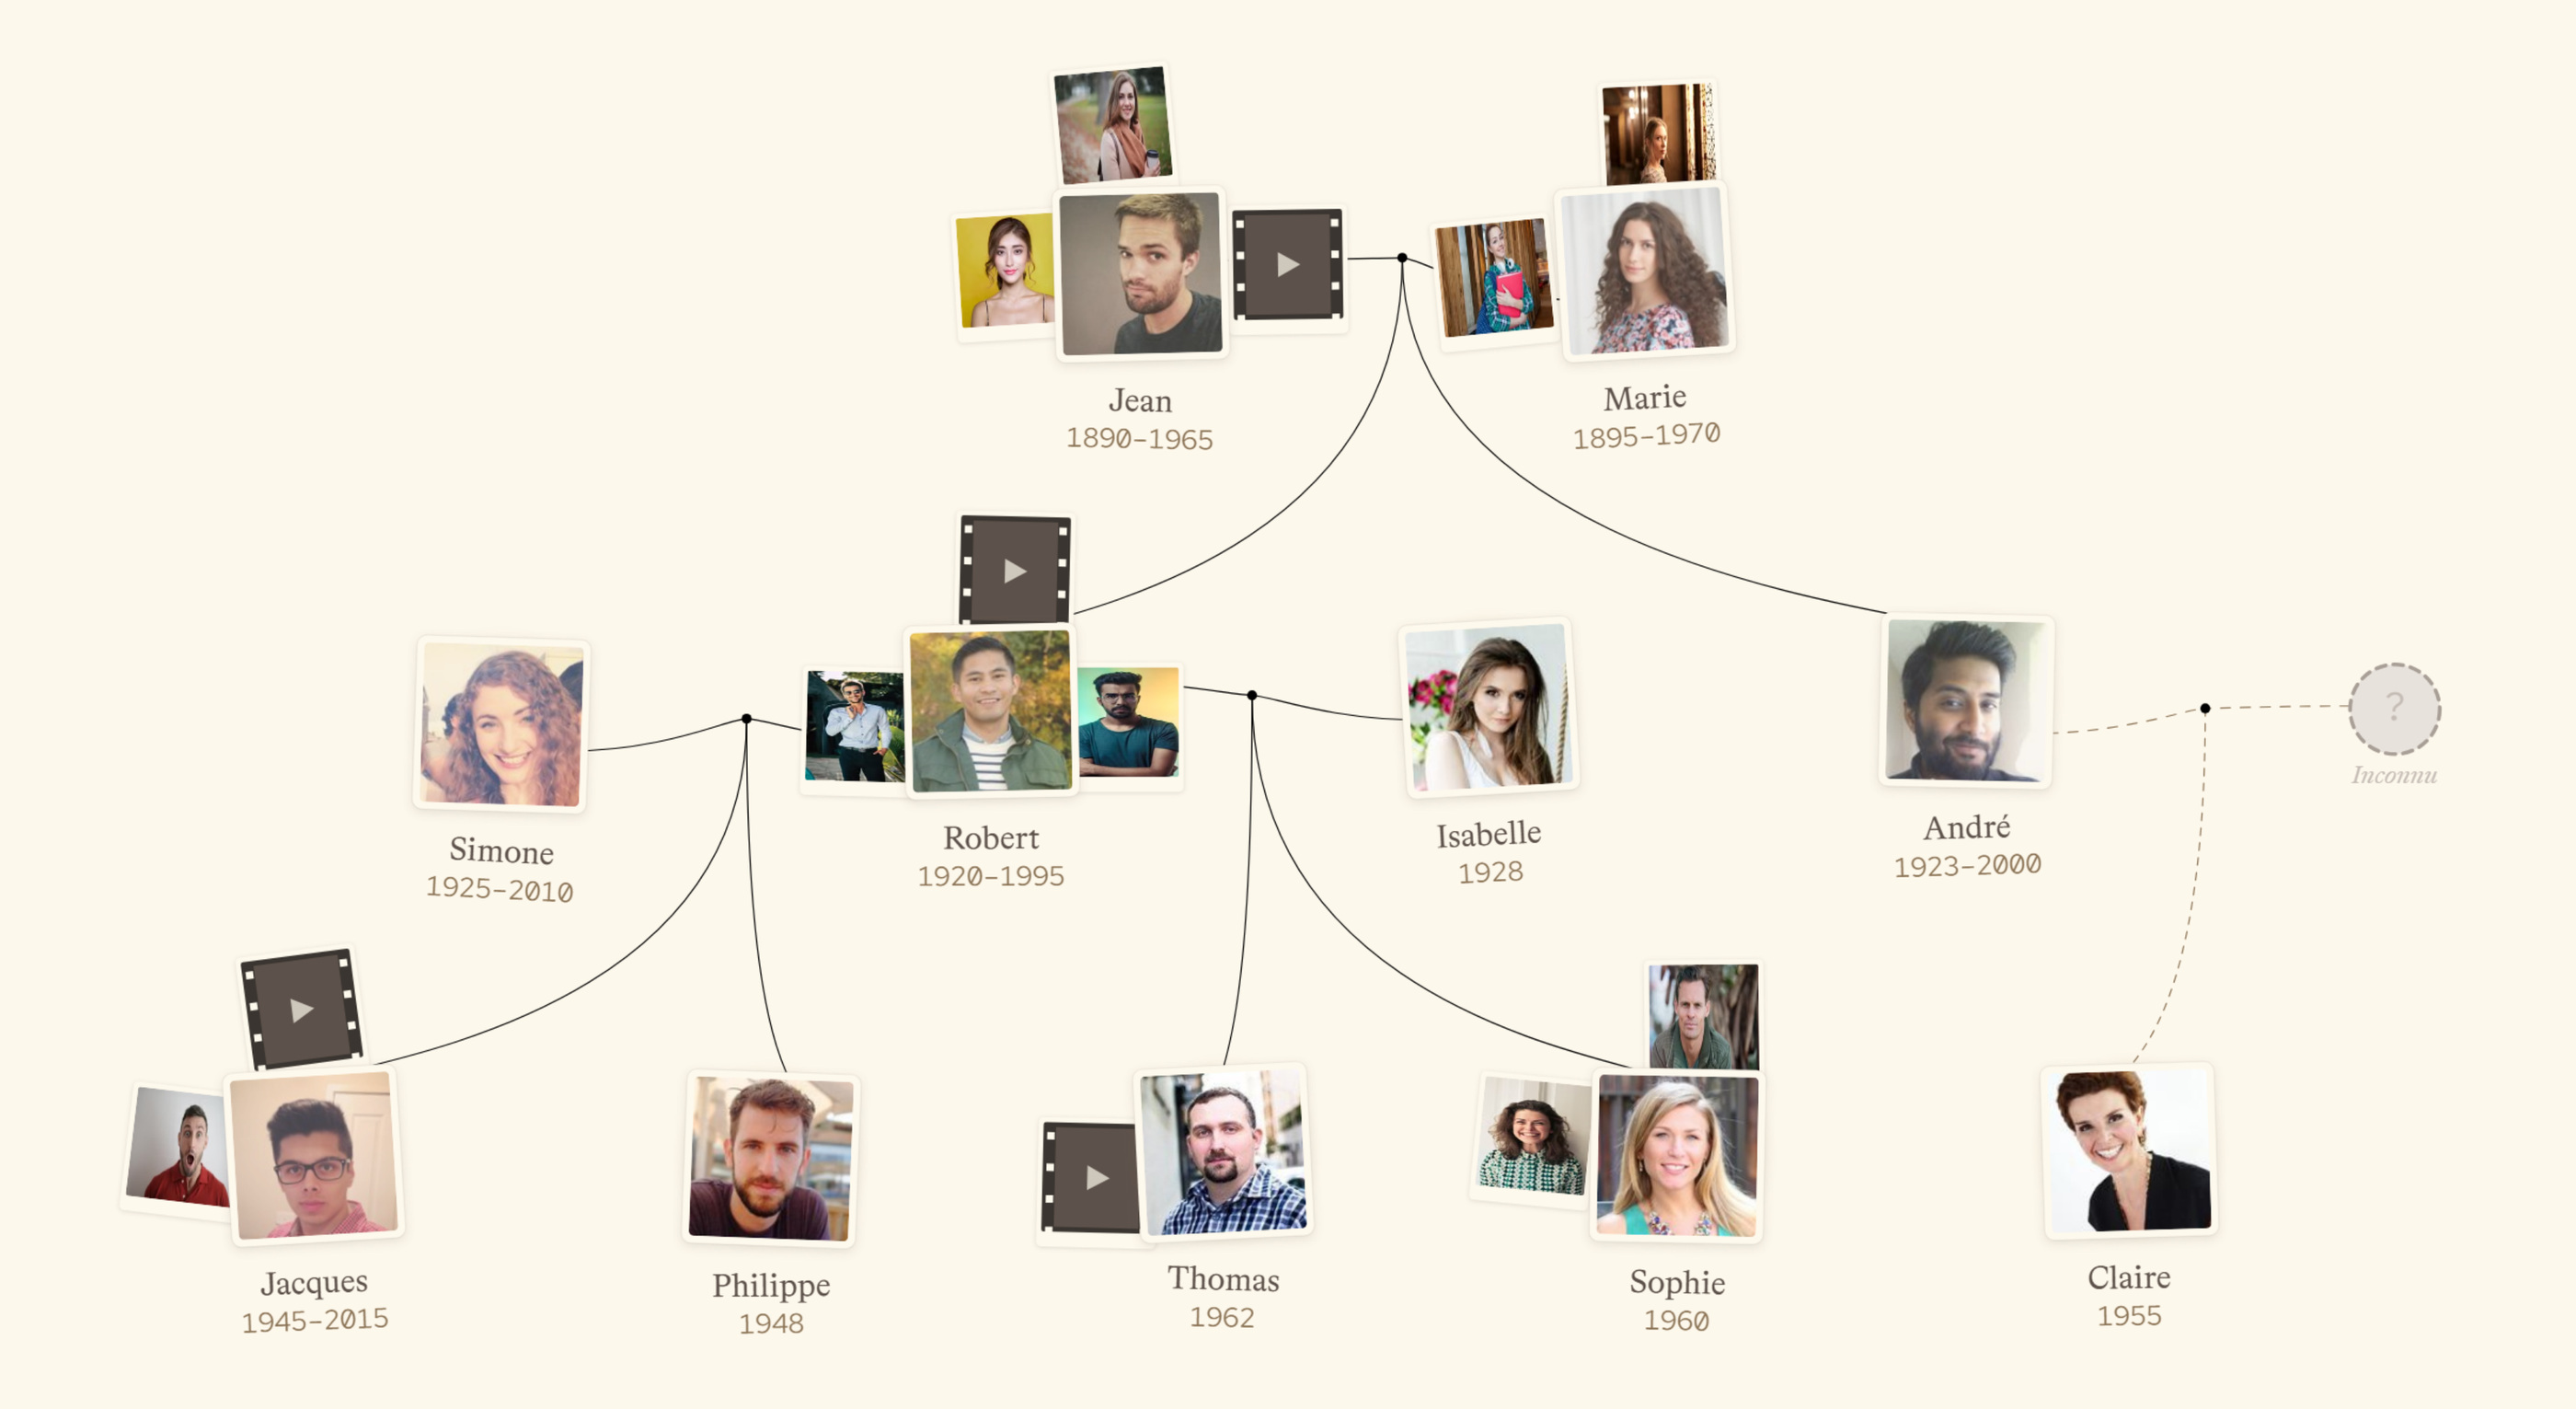
Ma mère a commencé l’arbre de la famille au crayon, sur un parchemin de plusieurs mètres. Dix planches plus tard elle ne pouvait plus l’étendre. J’ai construit Parenthèse pour ça, et son code est public depuis septembre.
Le point de départ
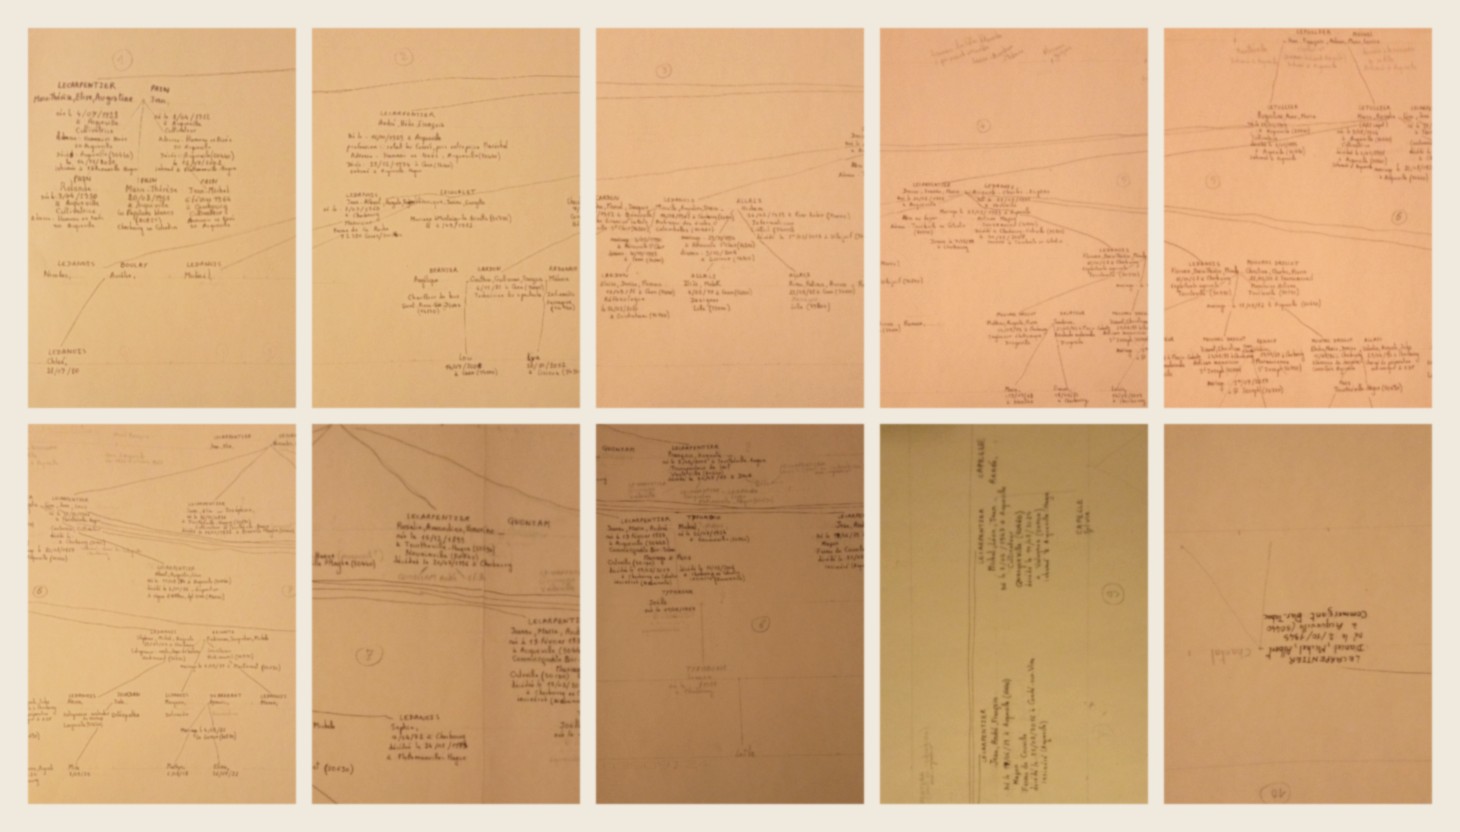
Le parchemin tient sur dix planches numérotées, avec des traits qui passent d’une feuille à l’autre. Chaque branche ajoutée obligeait à redécouper la mise en page, et personne d’autre qu’elle ne savait vraiment le lire.
On a cherché un outil en ligne. Ceux qu’on a trouvés demandent des dates précises, des sources et des actes à joindre, ils sont faits pour des gens qui font de la recherche. Ma mère ne fait pas de recherche, elle veut garder la photo de son grand-père, la voix de sa tante et l’histoire qui va avec.
Une carte plutôt qu’un tableau
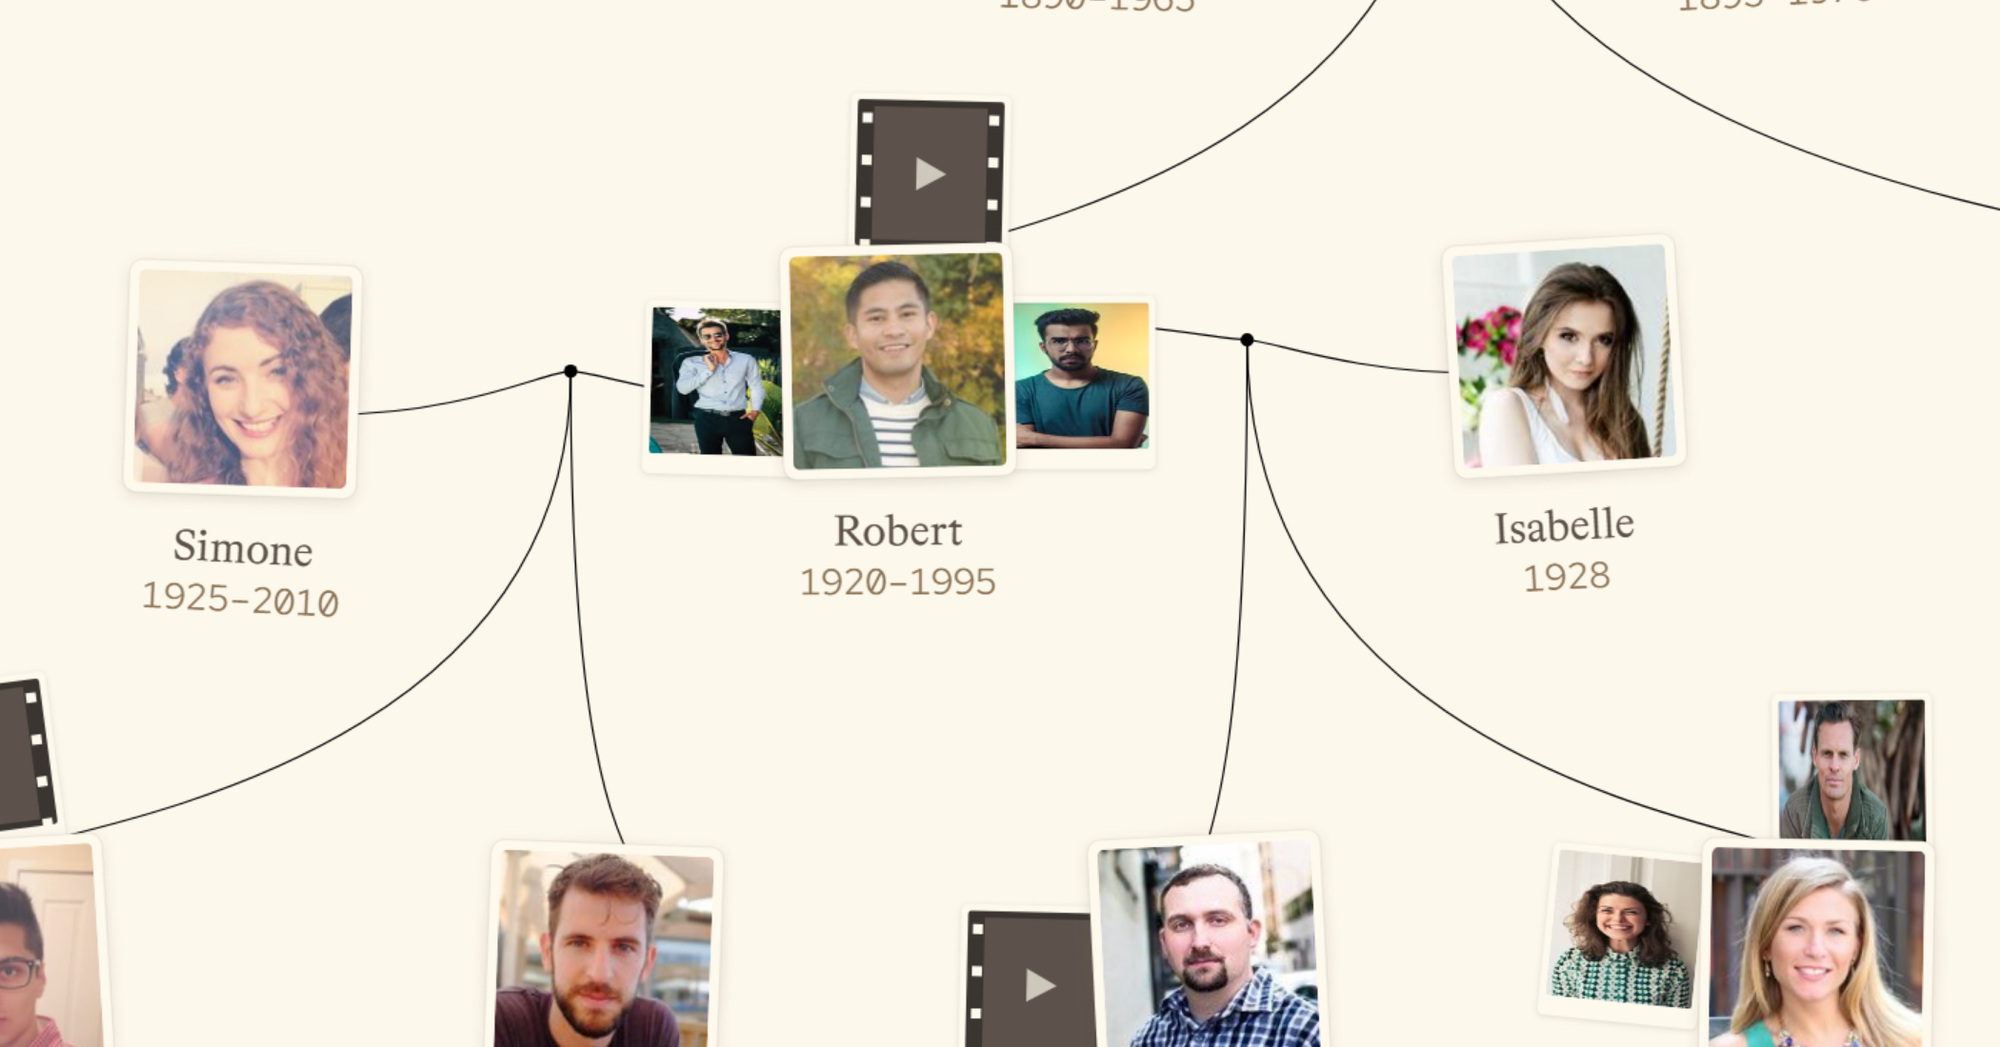
Le premier choix a été de ne pas faire un arbre à cases. Un tableau de générations se lit d’un coup d’œil tant qu’il tient sur un écran, et au-delà il devient un document qu’on fait défiler sans jamais voir où on est. J’ai préféré une carte dans laquelle on se déplace, chaque personne étant un point avec ses photos, ses vidéos et ses enregistrements audio autour.
Ce choix se paie, et j’ai passé une bonne partie du reste à le payer. Une carte fait perdre la vue d’ensemble, donc il a fallu une recherche, un cadrage automatique à l’ouverture et des niveaux de détail qui changent avec le zoom pour que l’écran reste lisible à toutes les échelles.
Lire sans compte, et ce que ça coûte
Un arbre s’ouvre avec un lien et un mot de passe de lecture, sans créer de compte. Un second mot de passe donne le droit de contribuer. C’est le réglage qui a fait que la famille s’en est servie, là où une inscription aurait arrêté la moitié des gens.
En contrepartie, l’application ne sait pas qui est derrière un mot de passe partagé, donc il n’y a pas d’historique nominatif des modifications. Les contributions, elles, passent par le propriétaire de l’arbre avant de s’afficher, une friction assumée que ma mère peut désactiver depuis ses réglages quand elle fait confiance à tout le monde.
Le vrai problème, placer 385 personnes
L’arbre de ma famille compte 385 personnes, 138 unions, 485 filiations et quinze générations. À cette taille, le placement cessait de ressembler à une famille. Un enfant se retrouvait en médiane à 394 pixels de l’union de ses parents, et dans le dernier décile à 1 689 pixels, soit quatorze largeurs de vignette. Deux sœurs pouvaient être à mille pixels l’une de l’autre.
La cause est dans la famille d’algorithmes que j’utilisais. Un placement en couches trie chaque génération indépendamment, par barycentre, et le bloc familial n’existe nulle part comme unité. Rien ne garantit donc que des parents soient au-dessus de leurs enfants.
J’ai monté un banc d’essai et comparé cinq familles de modèles en treize variantes, sur l’arbre réel plutôt que sur un jeu de test. Le plus instructif a été le moteur de placement de graphes laissé libre, qui sépare 94 couples sur 138 pour minimiser les croisements. Il fait exactement ce qu’on lui demande, et minimiser les croisements ne produit pas un arbre de famille.
En le contraignant, une chaîne de couples devenant un seul nœud avec des points d’attache fixes, les croisements tombent de 23 à une dizaine. Le calcul passe alors de 9 millisecondes à 500 ou 700, ce qui impose un worker, un état d’attente à l’écran et 300 kilo-octets de plus à télécharger. Et à l’œil, sur la même fenêtre, ça ne change rien à ce qui gênait.
Le modèle retenu abandonne ce moteur. Un couple et ses enfants forment un bloc, les blocs s’empilent par génération, et les parents sont centrés au-dessus de leurs enfants par construction plutôt que par heuristique. L’écart moyen parents-enfants passe de 210 à 179 pixels, la distance médiane d’un enfant à ses parents de 394 à 294, et le calcul reste à 9 millisecondes.
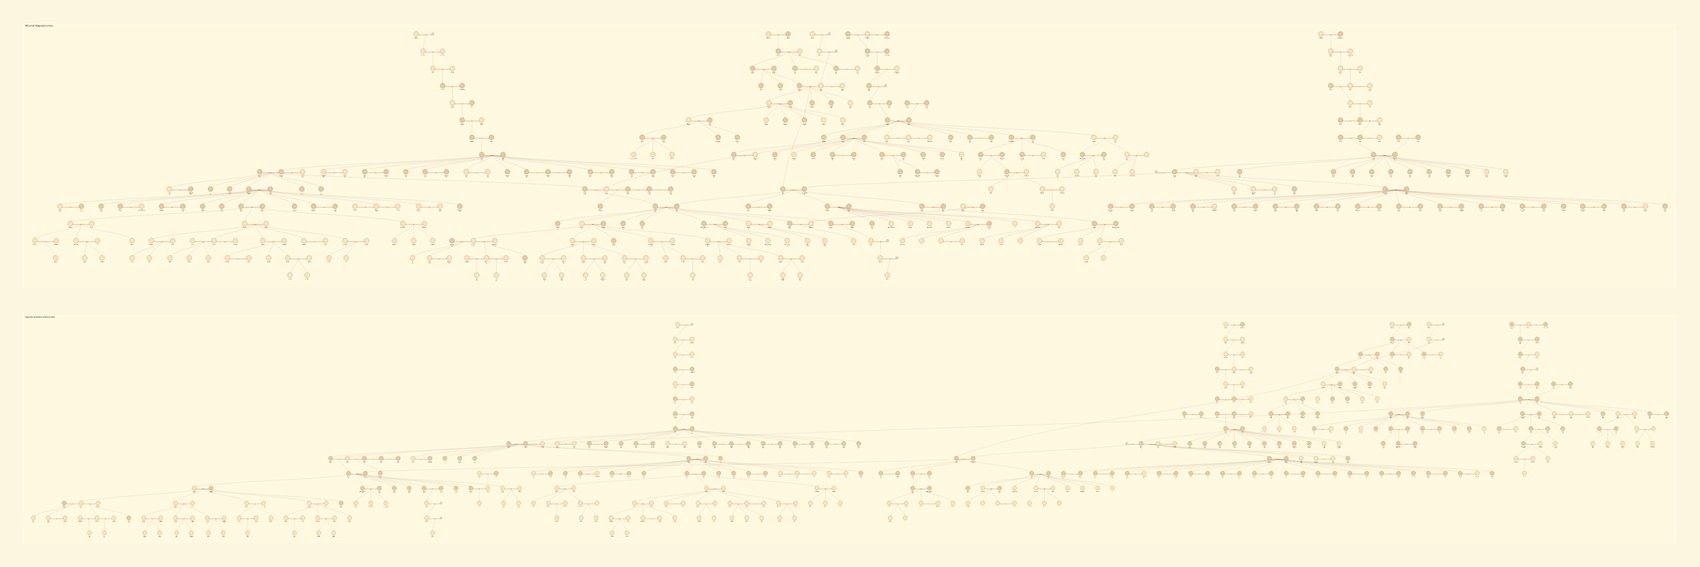
Ce modèle coûte 15 % de largeur en plus, et il laisse 25 croisements. Ils viennent des mariages entre deux familles déjà présentes dans l’arbre. La personne n’est placée qu’une fois, sous une seule de ses deux lignées, et aucun algorithme en couches ne supprime ça. On choisit seulement quelle lignée la garde.
J’ai testé quatre réglages du modèle et c’est le plus simple qui gagne. Une variante réduisait la largeur en réordonnant les enfants, le sous-arbre le plus large au centre, ce qui est la règle classique des arbres bien rangés. Je l’ai écartée parce que l’ordre de naissance compte plus, pour une famille, que quelques pour cent de largeur.
Une application qui tourne sur les machines de la famille
Le second problème était la fluidité. L’écran coûtait 12,7 millisecondes par image alors que personne ne touchait à rien. Le profil montrait 832 ombres portées et 779 dégradés radiaux dessinés à chaque image, plus deux fonctions qui parcouraient les 385 personnes et les 472 médias en linéaire pour chaque nœud, à chaque image.
Indexer ces recherches, ne dessiner que ce qui est à l’écran et simplifier le rendu quand on dézoome fait tomber le coût à 1,3 milliseconde. Ne redessiner que lorsque quelque chose a changé le ramène à 0,1. Au passage, j’ai coupé le flottement permanent des vignettes, qui obligeait à redessiner en continu pour un effet que personne ne regardait.
Les seuils de simplification sont des décisions de direction artistique plus que de performance. Les ombres disparaîtront sous un certain zoom, les années et l’orbite de médias un cran plus bas, le prénom s’estompe progressivement plutôt que de s’éteindre d’un coup. Le cadrage à l’ouverture suit la même logique, j’ai autorisé un dézoom plus large pour montrer davantage d’arbre, sans aller jusqu’à l’échelle qui ferait tenir les 385 personnes à l’écran avec des vignettes de dix pixels.
La question qui a décidé de l’ouverture
Cet arbre contient 472 médias, dont des enregistrements de gens qui ne sont plus là. Si j’arrête le service un jour, tout ça part avec lui. Je ne me voyais pas demander à d’autres familles de me confier la même chose en leur demandant de me croire sur parole.
Le code est donc public sous licence PolyForm Noncommercial. On peut le lire, le modifier et le faire tourner chez soi avec un docker compose up, il y a deux valeurs à remplir dans un fichier de configuration et c’est tout. Une licence permissive aurait laissé n’importe qui revendre le travail, et une licence libre classique n’empêche pas davantage l’usage commercial. Celle-ci autorise l’usage personnel et interdit le commerce, ce qui correspond exactement à ce que je voulais. Ce n’est pas de l’open source au sens strict et je ne fais pas semblant que ça l’est.
Où ça en est
Parenthèse est gratuit, ouvert à toutes les familles depuis septembre, et il n’y a aucune intelligence artificielle dedans parce que rien dans le parcours n’en demandait. La démo se visite sans compte sur parenthese.io et le dépôt est sur GitHub. Je réponds si quelqu’un veut l’héberger pour sa famille.